
Visualizzazioni: 0 Autore: Editor del sito Orario di pubblicazione: 27/10/2026 Origine: Sito


I dati aziendali si stanno espandendo a un ritmo impressionante. Raddoppia quasi ogni due anni poiché l’intelligenza artificiale, l’analisi dei big data e il cloud computing guidano una massiccia generazione di informazioni. L'hardware legacy crea gravi colli di bottiglia nelle prestazioni. Le velocità di accesso lente danneggiano direttamente le operazioni aziendali quotidiane. Man mano che le organizzazioni crescono, gli ambienti di storage tradizionali diventano rapidamente delle passività. Portano a vulnerabilità della sicurezza e costi di manutenzione esorbitanti. Per superare queste limitazioni, i leader IT necessitano di una soluzione moderna e affidabile.
L'impresa Storage Server System costituisce la base definitiva per un'infrastruttura dati altamente scalabile e a prova di futuro. Disaccoppiando l'elaborazione dallo storage, queste piattaforme progettate ad hoc assorbono facilmente carichi di lavoro imprevedibili. In questa guida completa esploreremo le architetture di storage avanzate, i vantaggi operativi e i framework di implementazione strategica. Vedremo anche come la selezione dell'hardware giusto possa favorire in modo significativo la crescita dei profitti aziendali.
Osservando il panorama attuale dell’infrastruttura IT, il passaggio all’analisi basata sull’intelligenza artificiale e all’edge computing ha cambiato radicalmente il modo in cui gestiamo i dati. L’industria si sta rapidamente allontanando dai silos di stoccaggio monolitici. Invece, le tendenze attuali favoriscono fortemente le architetture definite dal software abbinate a hardware NVMe ultra-denso. Questa transizione consente ai data center di elaborare grandi quantità di dati non strutturati in tempo reale. Non si tratta più solo di archiviare file; si tratta di alimentare modelli di machine learning affamati con flussi di dati ad alto throughput e a bassa latenza.
La scalabilità non è negoziabile: una solida architettura di storage consente alle aziende di scalare capacità e prestazioni senza problemi. Puoi espanderti senza interrompere le operazioni quotidiane o incorrere in tempi di inattività.
Le prestazioni incontrano la sicurezza: le soluzioni di livello aziendale combinano l'accesso ai dati ad alta velocità tramite NVMe e SSD con ridondanza avanzata. Sono inoltre dotati di meccanismi immutabili di protezione dei dati.
Architettura strategica: la realizzazione di un'infrastruttura dati scalabile richiede una valutazione approfondita dei carichi di lavoro attuali. È necessario scegliere i livelli di storage corretti e pianificare futuri massicci afflussi di dati.
Investimento intelligente: la scelta dell'hardware giusto riduce il costo totale di proprietà. Riduce il sovraccarico amministrativo, ottimizza l'utilizzo delle risorse e previene costosi cicli di sostituzione e sostituzione.
In un contesto aziendale, un sistema server di archiviazione è un'unità informatica specializzata e ad alte prestazioni. È dedicato esclusivamente all'archiviazione, alla gestione e alla protezione di enormi volumi di dati. I server standard danno priorità alla potenza di elaborazione per le applicazioni di hosting. Al contrario, questi sistemi robusti sono progettati da zero con densità di storage, integrità dei dati e input/output ad alto throughput come obiettivi primari.
I server di elaborazione generici sono progettati per gestire un'ampia varietà di attività. Assegnano pesantemente le risorse verso CPU ad alta frequenza e RAM estesa. I server di storage appositamente realizzati, tuttavia, sono meticolosamente ottimizzati per la conservazione e il recupero rapido dei dati. Questa divergenza architetturale determina il modo in cui le risorse vengono utilizzate durante le ore di punta operativa.
Caratteristica |
Server di elaborazione per uso generico |
Sistema server di storage dedicato |
|---|---|---|
Funzione primaria |
Hosting di applicazioni, attività di elaborazione |
Archiviazione, recupero e protezione dei dati |
Focus sull'hardware |
CPU ad alta frequenza, ampia RAM |
Alloggiamenti per unità ad alta densità, RAID hardware, memorizzazione nella cache massiccia |
Capacità di archiviazione |
Alloggiamenti interni limitati, in genere da 4 a 8 |
Alta densità, spesso 12, 24 o più di 36 alloggiamenti |
Rete |
Standard 1GbE o 10GbE |
Larghezza di banda elevata 25GbE, 100GbE o Fibre Channel |
Ridondanza |
Ridondanza di base dell'alimentazione |
Doppi controller attivi, percorsi interni ridondanti |
All'interno dei moderni ambienti IT, questi sistemi fungono da archivio centrale per le operazioni critiche. Forniscono l'infrastruttura backend necessaria per piattaforme di virtualizzazione, database transazionali e repository di backup centralizzati. Anche i cluster di calcolo ad alte prestazioni fanno molto affidamento su di essi. Centralizzando queste risorse, le organizzazioni allocano le risorse in modo più efficiente e mantengono protocolli di governance dei dati più rigorosi.
La crescita esponenziale dei dati aziendali significa che gli ambienti di storage statici non sono più sostenibili. Quando un sistema raggiunge la capacità o il limite IOPS, le prestazioni dell'applicazione diminuiscono immediatamente. Ciò ha un impatto diretto sulla produttività aziendale e sulla soddisfazione del cliente.
Recenti analisi di settore evidenziano un massiccio spostamento verso il cloud ibrido e i carichi di lavoro basati sull’intelligenza artificiale. Ciò costringe i leader IT a riconsiderare le configurazioni legacy. Gli analisti prevedono che nei prossimi cinque anni i dati non strutturati rappresenteranno oltre l’80% della crescita dello storage aziendale. Di conseguenza, l’implementazione di architetture che integrino perfettamente l’elaborazione localizzata ad alto rendimento con capacità altamente elastica è un imperativo per la sopravvivenza.
Per affrontare questa imprevedibile esplosione di dati, le organizzazioni devono comprendere i due metodi principali per scalare in modo efficace l'infrastruttura di storage. Il ridimensionamento verticale, o scale-up, implica l'aggiunta di più risorse a un sistema esistente. Gli amministratori possono espandere la capacità popolando gli alloggiamenti delle unità vuoti con unità di capacità maggiore o aggiornando i moduli di memorizzazione nella cache. Rappresenta una soluzione a breve termine altamente conveniente per la crescita dei dati localizzati.
La scalabilità orizzontale, o scalabilità orizzontale, implica l'aggiunta di ulteriori nodi del server di archiviazione a un cluster esistente. Il sistema distribuisce in modo intelligente dati e carichi di lavoro su tutti i nodi attivi. L'architettura scalabile aumenta contemporaneamente sia la capacità di storage che la potenza di elaborazione. Ciò lo rende ideale per ambienti su larga scala.
L'implementazione di un'architettura altamente scalabile previene attivamente il distruttivo ciclo di aggiornamento 'rip-and-replace'. I dipartimenti IT possono implementare hardware versatile che supporta sia l'espansione verticale che il clustering orizzontale. Ciò allinea perfettamente le spese in conto capitale infrastrutturali con la crescita effettiva del business, ottimizzando in modo significativo il ritorno sull’investimento a lungo termine.
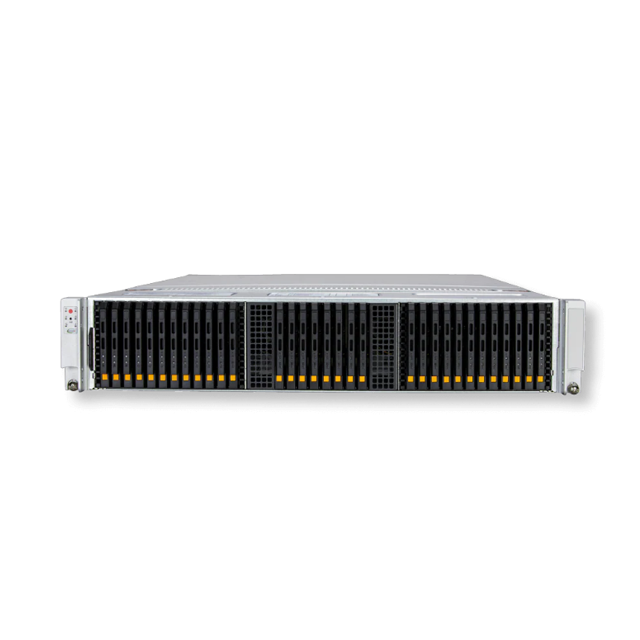
L'affidabilità dello storage aziendale si basa su una base hardware meticolosamente progettata. Comprendere questi componenti fisici è essenziale per valutare le capacità del sistema. Garantisce che soddisfino standard operativi rigorosi.
L'infrastruttura moderna utilizza storage multilivello intelligente per bilanciare prestazioni eccezionali con efficienza in termini di costi. Nello specifico, Non-Volatile Memory Express viene distribuito per dati importanti che richiedono una latenza estremamente bassa. Ciò include database finanziari attivi e cache di virtualizzazione. Le unità a stato solido standard vengono utilizzate per i dati caldi che richiedono un accesso rapido ma non richiedono prezzi premium. Inoltre, i dischi rigidi meccanici ad alta capacità rimangono lo standard indiscusso per i dati freddi, inclusi archivi a lungo termine e repository multimediali di grandi dimensioni.
In un ambiente aziendale, la perdita di dati semplicemente non è un’opzione. Le configurazioni hardware o software Redundant Array of Independent Disks proteggono da guasti catastrofici delle unità. Eseguendo il mirroring dei dati o calcolando i blocchi di parità su più unità, il sistema garantisce l'integrità dei dati. Se una o più unità si guastano, i dati rimangono completamente intatti e accessibili mentre l'hardware guasto viene sostituito a caldo.
Lo storage è veloce quanto la rete che lo collega ai server di elaborazione. Per prevenire paralizzanti colli di bottiglia, i sistemi aziendali utilizzano interfacce di rete a larghezza di banda elevata. Le distribuzioni standard ora richiedono 10 GbE o 25 GbE. Gli ambienti ad alte prestazioni che utilizzano array all-flash spesso richiedono connessioni da 100 GbE o Fibre Channel per sfruttare appieno la velocità di storage sottostante.
Per i leader e i decisori IT, l’aggiornamento dell’infrastruttura deve produrre vantaggi operativi misurabili. Il passaggio a un’architettura modernizzata trasforma radicalmente il modo in cui un’azienda opera quotidianamente.
I tempi di inattività del sistema si traducono direttamente in perdite di entrate e danni alla reputazione. Le piattaforme di fascia alta sono progettate con l'alta disponibilità al centro. Funzionalità come i doppi controller attivo-attivo, gli alimentatori ridondanti e le ventole di raffreddamento sostituibili a caldo assicurano che non vi sia assolutamente alcun punto di guasto. Se un componente primario si guasta, la sua controparte ridondante si assume immediatamente il carico di lavoro. Ciò garantisce tempi di inattività pari a zero per le applicazioni.
La gestione dei silos di storage frammentati è intrinsecamente inefficiente e altamente soggetta a errori umani. Un sistema unificato consente agli amministratori di gestire tutti i dati aziendali da un unico pannello di controllo. Questo approccio centralizzato riduce drasticamente il sovraccarico amministrativo dell'IT. Semplifica il provisioning dei volumi e ottimizza il monitoraggio delle prestazioni nell'intera organizzazione globale.
La rigorosa conformità normativa richiede misure rigorose di protezione dei dati. I sistemi moderni offrono funzionalità di sicurezza native e robuste. Questi includono la crittografia hardware integrata tramite unità di crittografia automatica e istantanee immutabili che impediscono al ransomware di alterare i dati di backup. I controlli granulari degli accessi basati sui ruoli garantiscono la sovranità assoluta dei dati.
La transizione verso un ambiente altamente scalabile richiede una meticolosa pianificazione strategica. I leader IT possono seguire questo framework strutturato per garantire un'implementazione di successo e un'integrazione operativa immediata.
Prima di acquistare nuovo hardware, le organizzazioni devono condurre un audit approfondito della loro attuale infrastruttura. Ciò comporta la misurazione dei requisiti IOPS di picco, l'analisi dell'utilizzo attuale della capacità e l'identificazione dei limiti di larghezza di banda della rete. I team IT dovrebbero prevedere la crescita dei dati su un orizzonte da tre a cinque anni in base alle tendenze storiche e alle prossime iniziative aziendali.
Selezionare una topologia che si allinei perfettamente ai requisiti del carico di lavoro è una decisione architetturale fondamentale. Una Storage Area Network fornisce spazio di archiviazione a livello di blocco a cui si accede tramite una rete ad alta velocità. Ciò lo rende ideale per i database che richiedono una latenza estremamente bassa. Network Attacked Storage offre storage a livello di file a cui si accede tramite Ethernet standard, più adatto per flussi di lavoro collaborativi. In alternativa, Direct attached storage si connette direttamente a un server specifico, utile per attività di elaborazione localizzate e ad alta velocità.
Gli amministratori devono configurare le policy di tiering automatizzate all'interno del software di gestione. Un sofisticato Il sistema server di storage della serie ST monitorerà dinamicamente i modelli di utilizzo dei dati. Promuove automaticamente i file a cui si accede di frequente ai livelli NVMe ad alta velocità. Nel frattempo, migra in modo trasparente i file dormienti su livelli di dischi rigidi ad alta capacità e convenienti durante le ore non di punta.
Lo storage primario deve essere perfettamente integrato in un piano completo di disaster recovery. Le organizzazioni devono configurare la replica asincrona o sincrona tra il sistema primario e i server di backup secondari. Questi dovrebbero essere ubicati in un data center fuori sede o in una destinazione cloud sicura, garantendo un rapido ripristino in caso di disastro a livello di sito.
Quando si valutano i fornitori di hardware, le caratteristiche tecniche specifiche determinano la fattibilità a lungo termine dell'investimento. I team di procurement devono guardare oltre i semplici parametri di capacità. Concentrarsi sulla potenza computazionale, sui vincoli fisici e sulle capacità di integrazione del software.
Lo spazio rack fisico in un data center è un bene prezioso. I team IT devono valutare se uno chassis con montaggio su rack 2U, 3U o 4U si adatta meglio ai propri vincoli di spazio. Valutare la densità dell'alloggiamento dell'unità è fondamentale. Ad esempio, l’implementazione di una soluzione come la serie ST offre un enorme vantaggio. Queste unità in genere presentano fino a 36 alloggiamenti per unità in uno chassis 4U ad alta densità, che supporta backplane NVMe avanzati. Ciò significa che ottieni il throughput grezzo richiesto per la virtualizzazione senza sacrificare lo spazio fisico sul rack.
Un moderno sistema di archiviazione è essenzialmente un computer altamente specializzato. Per eseguire in modo nativo i sistemi operativi di storage avanzati sono necessari potenti CPU multi-core e volumi elevati di RAM con codice di correzione degli errori. Queste risorse sono fondamentali per eseguire la deduplicazione in linea in tempo reale, la compressione dei dati e la crittografia crittografica rapida senza introdurre latenza di elaborazione.
L'hardware è efficace quanto il software che lo controlla. I decisori dovrebbero valutare il software di gestione fornito. Un'interfaccia utente grafica intuitiva, robusti meccanismi di avviso e integrazioni API fluide con hypervisor leader del settore sono obbligatori per l'allocazione automatizzata delle risorse.
I dati devono fluire rapidamente tra l'array di archiviazione e i nodi di elaborazione. Le organizzazioni dovrebbero cercare un Sistema server di storage aziendale che supporta più porte di rete 10GbE, 25GbE o 100GbE. L'ampio supporto per protocolli di rete avanzati garantisce che il sistema possa integrarsi perfettamente in diversi ambienti IT. Non avrai bisogno di una revisione completa della rete.
Per massimizzare la durata e il ritorno sull'investimento della tua infrastruttura, la manutenzione post-acquisto è altrettanto fondamentale quanto la distribuzione iniziale. Una routine di manutenzione dedicata garantisce prestazioni ottimali e mitiga i rischi emergenti per la sicurezza.
Il monitoraggio coerente funge da prima linea di difesa contro il degrado dell'hardware. Gli amministratori dovrebbero utilizzare strumenti di livello aziendale per monitorare lo stato delle unità, le prestazioni del controller e la latenza della rete. Stabilire un programma rigoroso per l'applicazione degli aggiornamenti del firmware del produttore garantisce che il sistema sia protetto dalle vulnerabilità appena scoperte.
Metrica di monitoraggio |
Descrizione |
Potenziale segnale di avvertimento |
|---|---|---|
IOPS |
Operazioni di input e output al secondo. |
Calo improvviso e inspiegabile della capacità IOPS di picco. |
Latenza |
Tempo impiegato per elaborare una singola richiesta di dati. |
Picchi di latenza costanti che superano le medie di base. |
Produttività |
Quantità di dati trasferiti al secondo. |
Gravi colli di bottiglia della rete durante i backup di routine. |
Integrità del disco |
Stato della tecnologia di automonitoraggio, analisi e reporting. |
Aumento graduale dei conteggi dei settori riallocati. |
Il degrado dello storage si verifica rapidamente quando un sistema supera l'80% della capacità. L'implementazione di avvisi di soglia automatizzati è una procedura consigliata. Esaminando regolarmente i report sulla capacità, gli amministratori possono prevedere con precisione quando il sistema raggiungerà i limiti critici. Ciò consente l'approvvigionamento e l'installazione di unità aggiuntive molto prima che le prestazioni diminuiscano.
L'hardware di storage ad alta densità genera calore significativo durante il funzionamento continuo. I data center devono rispettare rigorose linee guida del settore per quanto riguarda la temperatura ambiente e i livelli di umidità. Le unità di distribuzione dell'alimentazione ridondanti devono essere bilanciate in termini di carico. Dovrebbero collegarsi a gruppi di continuità separati per prevenire il degrado dell'hardware causato da stress termico o sovratensioni elettriche.
La corruzione silenziosa dei dati rappresenta una minaccia nascosta per gli archivi a lungo termine. I sistemi affidabili utilizzano processi di pulizia dei dati in background per rilevare e riparare automaticamente i settori danneggiati. Gli amministratori dovrebbero inoltre condurre verifiche trimestrali dei controlli di accesso degli utenti e delle autorizzazioni basate sui ruoli per proteggere i volumi sensibili.
I dati sono innegabilmente la linfa vitale di ogni impresa moderna. Poiché la generazione di informazioni continua ad accelerare, fare affidamento su infrastrutture obsolete rappresenta un grave rischio operativo. Per un successo duraturo è necessaria un’architettura robusta e altamente adattabile.
Investire in a Il sistema server di storage scalabile è molto più di un aggiornamento IT di routine. Si tratta di un vantaggio aziendale strategico che garantisce disponibilità continua, migliora la sicurezza e promuove l'efficienza operativa. Valutando oggi i tuoi attuali colli di bottiglia dello storage ed esplorando le soluzioni ad alte prestazioni della serie Vincanwo ST, puoi rendere i tuoi data center a prova di futuro e garantire una crescita aziendale duratura.
Mentre un dispositivo di storage collegato alla rete è un tipo specifico di storage, un server di storage aziendale rappresenta una categoria architettonica molto più ampia e potente. Un NAS standard è in genere progettato per l'archiviazione semplice a livello di file e la condivisione di documenti di base nella rete di un ufficio locale. Al contrario, un server di storage aziendale supporta lo storage a livello di blocco, un'enorme potenza di calcolo per la deduplica in tempo reale e architetture altamente complesse e scalabili. Questi robusti sistemi sono progettati per gestire carichi di lavoro impegnativi come la virtualizzazione su larga scala, che sovraccaricherebbe rapidamente un'appliance NAS standard.
Il ciclo di vita operativo standard dell'hardware di storage aziendale varia generalmente da tre a cinque anni. Tuttavia, un'architettura altamente scalabile può estendere efficacemente questa durata funzionale. Utilizzando progetti modulari, le aziende possono eseguire aggiornamenti fisici senza interruzioni. Puoi sostituire i dischi rigidi più vecchi con unità NVMe ad alta capacità o aggiungere nuovi nodi di calcolo a un cluster scalabile. Con una manutenzione proattiva, un sistema ben progettato può rimanere vitale fino a sette anni.
Sì, questa configurazione è ampiamente conosciuta come array di archiviazione ibrido. Un sofisticato sistema integra perfettamente sia le unità a stato solido che le unità disco rigido all'interno dello stesso chassis fisico. Il sistema utilizza un software di classificazione automatizzata dei dati per gestire il posizionamento dei dati in modo dinamico in base ai modelli di utilizzo. Mantiene i dati hot a cui si accede di frequente sul livello a stato solido ultraveloce mentre migra i dati freddi al livello del disco rigido conveniente.
I dati aziendali crescono in modo imprevedibile a causa di fattori come l’integrazione dell’intelligenza artificiale e periodi prolungati di conservazione della conformità. Un'architettura scalabile impedisce alle aziende di scontrarsi inaspettatamente con un limite di capacità. La scalabilità consente ai dipartimenti IT di aggiungere capacità o nodi di prestazioni in modo incrementale. Ciò allinea le spese in conto capitale direttamente alla crescita effettiva del business e garantisce operazioni quotidiane ininterrotte.
Il termine livello aziendale indica una rigorosa filosofia di progettazione incentrata sull'assenza di singoli punti di guasto e sulla disponibilità continua dei dati. Un vero sistema aziendale include doppi controller di storage attivo-attivo, unità sostituibili a caldo e alimentatori ridondanti. Dispone inoltre di servizi dati avanzati come RAID con accelerazione hardware, replica sincrona e snapshot immutabili per la protezione dai ransomware.
Il calcolo della capacità per i carichi di lavoro AI richiede l'analisi delle dimensioni dei set di dati di addestramento, della frequenza di acquisizione dei dati e delle policy di conservazione per i modelli generati. A differenza dei database tradizionali, i carichi di lavoro dell’intelligenza artificiale gestiscono enormi quantità di dati non strutturati come immagini, video e file di registro. Gli ingegneri in genere stabiliscono una linea di base moltiplicando la dimensione attuale del set di dati per il tasso di crescita previsto su tre anni, tenendo conto di un buffer aggiuntivo dal 20 al 30% per lo spazio di lavoro e i file di elaborazione temporanei durante l'addestramento del modello.
Il RAID hardware si basa su una scheda controller fisica dedicata installata all'interno del server per gestire la parità dei dati e la ridondanza delle unità. Scarica l'elaborazione dalla CPU principale, offrendo prestazioni altamente affidabili per array localizzati. Lo storage definito dal software, d'altro canto, astrae la gestione dello storage dall'hardware sottostante. Utilizza la CPU e la RAM principali del server per gestire i dati su più nodi, consentendo un'enorme scalabilità orizzontale e funzionalità avanzate come la codifica di cancellazione, che sono essenziali per le moderne infrastrutture cloud e scalabili.


