
Wyświetlenia: 0 Autor: Edytor witryny Czas publikacji: 27.10.2026 Pochodzenie: Strona


Dane przedsiębiorstwa rozwijają się w zawrotnym tempie. Podwaja się niemal co dwa lata, ponieważ sztuczna inteligencja, analiza dużych zbiorów danych i przetwarzanie w chmurze napędzają masowe generowanie informacji. Starszy sprzęt powoduje poważne wąskie gardła w zakresie wydajności. Niskie prędkości dostępu bezpośrednio szkodzą codziennym operacjom biznesowym. W miarę skalowania organizacji tradycyjne środowiska pamięci masowej szybko stają się zobowiązaniami. Prowadzą do luk w zabezpieczeniach i wygórowanych kosztów utrzymania. Aby pokonać te ograniczenia, liderzy IT potrzebują nowoczesnego, niezawodnego rozwiązania.
Przedsiębiorstwo System serwerów pamięci masowej stanowi najlepszą podstawę przyszłościowej, wysoce skalowalnej infrastruktury danych. Oddzielając moc obliczeniową od pamięci masowej, te specjalnie zaprojektowane platformy bez problemu radzą sobie z nieprzewidywalnymi obciążeniami. W tym obszernym przewodniku omówimy zaawansowane architektury pamięci masowej, korzyści operacyjne i ramy wdrażania strategicznego. Przyjrzymy się również, jak wybór odpowiedniego sprzętu może znacząco wpłynąć na wzrost zysków firmy.
Patrząc na obecny krajobraz infrastruktury IT, przejście w kierunku analityki opartej na sztucznej inteligencji i przetwarzania brzegowego zasadniczo zmieniło sposób, w jaki obchodzimy się z danymi. Branża szybko odchodzi od monolitycznych silosów magazynowych. Zamiast tego obecne trendy w dużym stopniu faworyzują architektury definiowane programowo w połączeniu z ultragęstym sprzętem NVMe. To przejście umożliwia centrom danych przetwarzanie ogromnych jezior nieustrukturyzowanych danych w czasie rzeczywistym. Nie chodzi już tylko o przechowywanie plików; chodzi o zasilanie głodnych modeli uczenia maszynowego strumieniami danych o dużej przepustowości i małych opóźnieniach.
Skalowalność nie podlega negocjacjom: solidna architektura pamięci masowej umożliwia firmom płynne skalowanie pojemności i wydajności. Możesz rozwijać się bez zakłócania codziennych operacji i przestojów.
Wydajność i bezpieczeństwo: rozwiązania klasy korporacyjnej łączą szybki dostęp do danych za pośrednictwem NVMe i dysków SSD z zaawansowaną redundancją. Posiadają również niezmienne mechanizmy ochrony danych.
Architektura strategiczna: budowanie skalowalnej infrastruktury danych wymaga dokładnej oceny bieżących obciążeń. Musisz wybrać odpowiednie poziomy pamięci masowej i zaplanować masowy przyszły napływ danych.
Inteligentna inwestycja: wybór odpowiedniego sprzętu obniża całkowity koszt posiadania. Zmniejsza obciążenie administracyjne, optymalizuje wykorzystanie zasobów i zapobiega kosztownym cyklom wymiany i wymiany.
W kontekście korporacyjnym system serwerów pamięci masowej to wyspecjalizowana jednostka obliczeniowa o wysokiej wydajności. Jest przeznaczony wyłącznie do przechowywania, zarządzania i zabezpieczania ogromnych ilości danych. Serwery standardowe traktują priorytetowo moc obliczeniową dla aplikacji hostujących. Natomiast te solidne systemy są projektowane od podstaw, a ich głównymi celami są gęstość przechowywania, integralność danych i wysoka przepustowość wejścia/wyjścia.
Serwery obliczeniowe ogólnego przeznaczenia zaprojektowano do obsługi szerokiej gamy zadań. W dużym stopniu przeznaczają zasoby na procesory o wysokiej częstotliwości i obszerną pamięć RAM. Jednakże specjalnie zaprojektowane serwery pamięci masowej są skrupulatnie zoptymalizowane pod kątem przechowywania i szybkiego wyszukiwania danych. Ta rozbieżność architektoniczna decyduje o sposobie wykorzystania zasobów w godzinach szczytu.
Funkcja |
Serwer obliczeniowy ogólnego przeznaczenia |
Dedykowany system serwerów pamięci masowej |
|---|---|---|
Funkcja podstawowa |
Hosting aplikacji, zadania przetwarzania |
Przechowywanie, odzyskiwanie i ochrona danych |
Koncentracja na sprzęcie |
Procesory wysokiej częstotliwości, obszerna pamięć RAM |
Gęste wnęki na dyski, sprzętowa macierz RAID, ogromne buforowanie |
Pojemność pamięci |
Ograniczona liczba wnęk wewnętrznych, zazwyczaj od 4 do 8 |
Wysoka gęstość, często 12, 24 lub 36 wnęk plus |
Sieć |
Standardowo 1GbE lub 10GbE |
Wysoka przepustowość 25GbE, 100GbE lub Fibre Channel |
Nadmierność |
Podstawowa redundancja zasilania |
Podwójne aktywne kontrolery, redundantne ścieżki wewnętrzne |
W nowoczesnych środowiskach IT systemy te pełnią rolę centralnego repozytorium krytycznych operacji. Zapewniają niezbędną infrastrukturę backendową dla platform wirtualizacyjnych, transakcyjnych baz danych i scentralizowanych repozytoriów kopii zapasowych. Klastry obliczeń dużej wydajności również w dużym stopniu na nich polegają. Centralizując te zasoby, organizacje efektywniej alokują zasoby i utrzymują bardziej rygorystyczne protokoły zarządzania danymi.
Gwałtowny wzrost ilości danych w przedsiębiorstwach oznacza, że statyczne środowiska pamięci masowej nie są już opłacalne. Gdy system osiągnie swoją pojemność lub limit IOPS, wydajność aplikacji natychmiast spada. Ma to bezpośredni wpływ na produktywność firmy i satysfakcję klientów.
Najnowsze analizy branżowe podkreślają masową zmianę w kierunku obciążeń opartych na chmurze hybrydowej i sztucznej inteligencji. Zmusza to liderów IT do ponownego przemyślenia starszych konfiguracji. Analitycy przewidują, że w ciągu najbliższych pięciu lat dane nieustrukturyzowane będą odpowiadać za ponad 80% wzrostu pamięci masowej w przedsiębiorstwach. W rezultacie wdrażanie architektur, które płynnie integrują lokalne przetwarzanie o dużej przepustowości z wysoce elastyczną wydajnością, jest koniecznością przetrwania.
Aby zaradzić tej nieprzewidywalnej eksplozji danych, organizacje muszą poznać dwie podstawowe metody skutecznego skalowania infrastruktury pamięci masowej. Skalowanie w pionie lub zwiększanie skali polega na dodawaniu większej liczby zasobów do istniejącego systemu. Administratorzy mogą zwiększać pojemność, zapełniając puste wnęki dyskami dyskami o większej pojemności lub modernizując moduły pamięci podręcznej. Służy jako wysoce opłacalne, krótkoterminowe rozwiązanie do lokalnego wzrostu ilości danych.
Skalowanie poziome lub skalowanie w poziomie obejmuje dodawanie dodatkowych węzłów serwera pamięci masowej do istniejącego klastra. System inteligentnie rozdziela dane i obciążenia pomiędzy wszystkie aktywne węzły. Skalowalna architektura zwiększa jednocześnie pojemność pamięci masowej i moc obliczeniową. Dzięki temu idealnie nadaje się do środowisk o dużej skali.
Wdrożenie wysoce skalowalnej architektury aktywnie zapobiega zakłócającemu cyklowi aktualizacji typu „zgraj i wymień”. Działy IT mogą wdrożyć wszechstronny sprzęt, który obsługuje zarówno rozbudowę pionową, jak i klastry poziome. To doskonale dostosowuje wydatki inwestycyjne na infrastrukturę do rzeczywistego rozwoju biznesu, znacząco optymalizując długoterminowy zwrot z inwestycji.
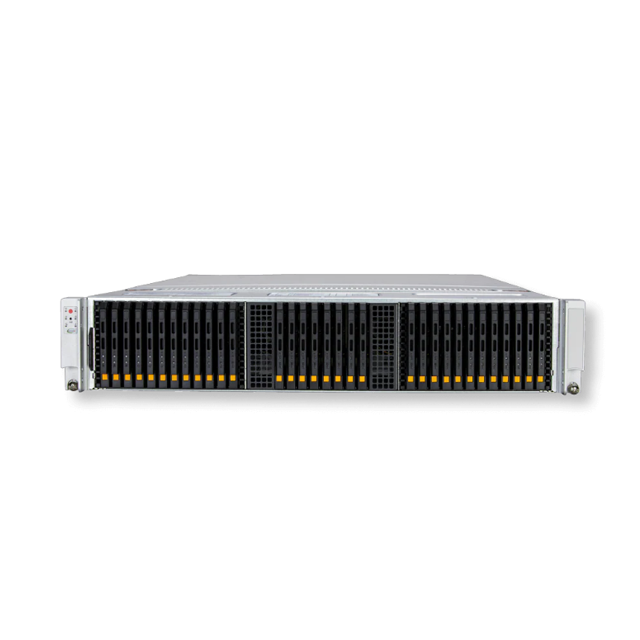
Niezawodność pamięci masowej dla przedsiębiorstw opiera się na starannie zaprojektowanym fundamencie sprzętowym. Zrozumienie tych komponentów fizycznych jest niezbędne do oceny możliwości systemu. Dzięki temu spełniają one rygorystyczne standardy operacyjne.
Nowoczesna infrastruktura wykorzystuje inteligentną wielopoziomową pamięć masową, aby zrównoważyć niesamowitą wydajność z opłacalnością. W szczególności Non-Volatile Memory Express jest wdrażany w przypadku gorących danych wymagających bardzo małych opóźnień. Obejmuje to aktywne finansowe bazy danych i pamięci podręczne wirtualizacji. Standardowe dyski półprzewodnikowe są wykorzystywane do przechowywania „ciepłych” danych, które wymagają szybkiego dostępu, ale nie wymagają wysokich cen. Co więcej, mechaniczne dyski twarde o dużej pojemności pozostają niekwestionowanym standardem w przypadku zimnych danych, w tym archiwów długoterminowych i dużych repozytoriów multimediów.
W środowisku korporacyjnym utrata danych po prostu nie wchodzi w grę. Konfiguracje sprzętowe lub programowe z nadmiarową macierzą niezależnych dysków chronią przed katastrofalnymi awariami dysków. Odbijając dane lub obliczając bloki parzystości na wielu dyskach, system gwarantuje integralność danych. Jeśli jeden lub więcej dysków ulegnie awarii, dane pozostaną nienaruszone i dostępne, podczas gdy uszkodzony sprzęt będzie wymieniany podczas pracy.
Pamięć masowa jest tak szybka, jak sieć łącząca ją z serwerami obliczeniowymi. Aby zapobiec powstawaniu wąskich gardeł, systemy korporacyjne korzystają z interfejsów sieciowych o dużej przepustowości. Wdrożenia standardowe wymagają teraz sieci 10GbE lub 25GbE. Środowiska o wysokiej wydajności wykorzystujące macierze all-flash często wymagają połączeń 100GbE lub Fibre Channel, aby w pełni wykorzystać podstawową prędkość pamięci masowej.
Liderom IT i decydentom modernizacja infrastruktury musi dawać wymierne korzyści operacyjne. Przejście na zmodernizowaną architekturę zasadniczo zmienia sposób, w jaki firma działa na co dzień.
Przestój systemu bezpośrednio przekłada się na utratę przychodów i zniszczoną reputację. Platformy najwyższej klasy zostały zaprojektowane z myślą o wysokiej dostępności. Funkcje takie jak dwa kontrolery typu aktywny-aktywny, nadmiarowe zasilacze i wentylatory chłodzące z możliwością wymiany podczas pracy zapewniają, że nie ma żadnego pojedynczego punktu awarii. Jeśli główny komponent ulegnie awarii, obciążenie natychmiast przejmuje jego nadmiarowy odpowiednik. Zapewnia to zerowy czas przestojów aplikacji.
Zarządzanie pofragmentowanymi silosami magazynowymi jest z natury nieefektywne i wysoce podatne na błędy ludzkie. Ujednolicony system umożliwia administratorom zarządzanie wszystkimi danymi przedsiębiorstwa z jednego panelu. To scentralizowane podejście drastycznie zmniejsza obciążenie administracyjne IT. Upraszcza przydzielanie woluminów i usprawnia monitorowanie wydajności w całej globalnej organizacji.
Ścisła zgodność z przepisami wymaga rygorystycznych środków ochrony danych. Nowoczesne systemy oferują natywne, solidne funkcje bezpieczeństwa. Obejmują one wbudowane szyfrowanie sprzętowe za pośrednictwem dysków samoszyfrujących i niezmienne migawki, które uniemożliwiają oprogramowaniu ransomware zmianę danych kopii zapasowych. Szczegółowa kontrola dostępu oparta na rolach zapewnia całkowitą suwerenność danych.
Przejście do wysoce skalowalnego środowiska wymaga skrupulatnego planowania strategicznego. Liderzy IT mogą przestrzegać tych ustrukturyzowanych ram, aby zapewnić pomyślne wdrożenie i natychmiastową integrację operacyjną.
Przed zakupem nowego sprzętu organizacje muszą przeprowadzić dokładny audyt swojej obecnej infrastruktury. Obejmuje to pomiar szczytowych wymagań IOPS, analizę bieżącego wykorzystania przepustowości i identyfikację limitów przepustowości sieci. Zespoły IT powinny prognozować wzrost danych w horyzoncie trzech do pięciu lat w oparciu o trendy historyczne i nadchodzące inicjatywy biznesowe.
Wybór topologii, która idealnie odpowiada wymaganiom obciążenia, jest kluczową decyzją architektoniczną. Sieć pamięci masowej zapewnia pamięć masową na poziomie bloków, do której można uzyskać dostęp za pośrednictwem szybkiej sieci. Dzięki temu idealnie nadaje się do baz danych wymagających bardzo małych opóźnień. Sieciowa pamięć masowa zapewnia pamięć na poziomie plików, do której można uzyskać dostęp poprzez standardową sieć Ethernet, najlepiej dostosowaną do wspólnych przepływów pracy. Alternatywnie, pamięć masowa dołączana bezpośrednio łączy się bezpośrednio z określonym serwerem, co jest przydatne w przypadku zlokalizowanych zadań przetwarzania o dużej szybkości.
Administratorzy muszą skonfigurować zasady automatycznego podziału na warstwy w oprogramowaniu do zarządzania. Wyrafinowany System serwerów pamięci masowej serii ST będzie dynamicznie monitorować wzorce wykorzystania danych. Automatycznie awansuje często używane pliki do szybkich warstw NVMe. Jednocześnie w przejrzysty sposób migruje uśpione pliki na ekonomiczne dyski twarde o dużej pojemności poza godzinami szczytu.
Podstawowa pamięć masowa musi być bezbłędnie zintegrowana z kompleksowym planem odzyskiwania danych po awarii. Organizacje powinny skonfigurować replikację asynchroniczną lub synchroniczną pomiędzy systemem głównym a dodatkowymi serwerami kopii zapasowych. Powinny one być zlokalizowane w zewnętrznym centrum danych lub w bezpiecznym miejscu docelowym w chmurze, co zapewni szybkie przywrócenie działania w przypadku awarii obejmującej całą placówkę.
Przy ocenie dostawców sprzętu specyficzne cechy techniczne decydują o długoterminowej rentowności inwestycji. Zespoły zakupowe muszą patrzeć poza surowe wskaźniki wydajności. Skoncentruj się na mocy obliczeniowej, ograniczeniach fizycznych i możliwościach integracji oprogramowania.
Fizyczna przestrzeń w szafie w centrum danych to towar premium. Zespoły IT muszą ocenić, czy obudowa do montażu w szafie o wysokości 2U, 3U lub 4U najlepiej pasuje do ich ograniczeń przestrzennych. Ocena gęstości wnęki na napęd ma kluczowe znaczenie. Na przykład wdrożenie rozwiązania takiego jak seria ST zapewnia ogromną przewagę. Jednostki te zazwyczaj posiadają do 36 kieszeni na dyski w obudowie 4U o dużej gęstości i obsługują zaawansowane płyty montażowe NVMe. Oznacza to, że uzyskujesz surową przepustowość wymaganą do wirtualizacji bez poświęcania fizycznej przestrzeni w szafie.
Nowoczesny system przechowywania danych to zasadniczo wysoce wyspecjalizowany komputer. Do natywnego uruchamiania zaawansowanych systemów operacyjnych pamięci masowej niezbędne są wydajne wielordzeniowe procesory i duża ilość pamięci RAM z kodem korygującym błędy. Zasoby te mają kluczowe znaczenie dla wykonywania deduplikacji inline w czasie rzeczywistym, kompresji danych i szybkiego szyfrowania kryptograficznego bez powodowania opóźnień przetwarzania.
Sprzęt jest tak skuteczny, jak kontrolowane przez niego oprogramowanie. Decydenci powinni ocenić dostarczone oprogramowanie zarządzające. Intuicyjny graficzny interfejs użytkownika, niezawodne mechanizmy ostrzegania i płynna integracja API z wiodącymi w branży hypervisorami są niezbędne do automatycznej alokacji zasobów.
Dane muszą szybko przepływać między macierzą pamięci masowej a węzłami obliczeniowymi. Organizacje powinny szukać System serwerów pamięci masowej dla przedsiębiorstw obsługujący wiele portów sieciowych 10GbE, 25GbE lub 100GbE. Szerokie wsparcie dla zaawansowanych protokołów sieciowych gwarantuje bezproblemową integrację systemu z różnorodnymi środowiskami IT. Nie będziesz potrzebować całkowitej przebudowy sieci.
Aby zmaksymalizować żywotność i zwrot z inwestycji w infrastrukturę, konserwacja po zakupie jest tak samo ważna jak początkowe wdrożenie. Dedykowana procedura konserwacji zapewnia optymalną wydajność i ogranicza pojawiające się zagrożenia bezpieczeństwa.
Konsekwentne monitorowanie stanowi pierwszą linię obrony przed degradacją sprzętu. Administratorzy powinni korzystać z narzędzi klasy korporacyjnej do śledzenia stanu dysku, wydajności kontrolera i opóźnień sieci. Ustanowienie ścisłego harmonogramu stosowania aktualizacji oprogramowania sprzętowego producenta zapewnia ochronę systemu przed nowo wykrytymi lukami.
Wskaźnik monitorowania |
Opis |
Potencjalny znak ostrzegawczy |
|---|---|---|
IOPS |
Operacje wejściowe i wyjściowe na sekundę. |
Niewyjaśniony nagły spadek szczytowej wydajności IOPS. |
Utajenie |
Czas potrzebny na przetworzenie pojedynczego żądania danych. |
Stałe skoki opóźnień przekraczające średnie wartości bazowe. |
Przepustowość |
Ilość danych przesłanych na sekundę. |
Poważne wąskie gardła w sieci podczas rutynowych kopii zapasowych. |
Kondycja dysku |
Samokontrola, analiza i raportowanie stanu technologii. |
Stopniowy wzrost liczby realokowanych sektorów. |
Degradacja pamięci następuje szybko, gdy pojemność systemu przekracza 80%. Najlepszym rozwiązaniem jest wdrożenie automatycznych alertów progowych. Regularnie przeglądając raporty dotyczące wydajności, administratorzy mogą dokładnie przewidzieć, kiedy system osiągnie limity krytyczne. Umożliwia to zakup i instalację dodatkowych dysków na długo przed spadkiem wydajności.
Gęsty sprzęt do przechowywania generuje znaczną ilość ciepła podczas ciągłej pracy. Centra danych muszą przestrzegać ścisłych wytycznych branżowych dotyczących poziomów temperatury i wilgotności otoczenia. Nadmiarowe jednostki dystrybucji mocy muszą być równoważone pod względem obciążenia. Powinny być podłączone do oddzielnych zasilaczy awaryjnych, aby zapobiec degradacji sprzętu spowodowanej naprężeniami termicznymi lub przepięciami elektrycznymi.
Ciche uszkodzenie danych stanowi ukryte zagrożenie dla archiwów długoterminowych. Niezawodne systemy wykorzystują procesy czyszczenia danych w tle w celu automatycznego wykrywania i naprawy uszkodzonych sektorów. Administratorzy powinni także przeprowadzać kwartalne audyty kontroli dostępu użytkowników i uprawnień opartych na rolach, aby zabezpieczyć wrażliwe woluminy.
Dane są niezaprzeczalnie siłą napędową każdego nowoczesnego przedsiębiorstwa. Ponieważ wytwarzanie informacji stale przyspiesza, poleganie na przestarzałej infrastrukturze wiąże się z poważnym ryzykiem operacyjnym. Aby osiągnąć trwały sukces, niezbędna jest solidna architektura o dużych możliwościach adaptacji.
Inwestowanie w skalowalny system serwerów pamięci masowej to znacznie więcej niż rutynowa aktualizacja IT. Jest to strategiczna przewaga biznesowa, która zapewnia ciągłą dostępność, zwiększa bezpieczeństwo i zwiększa efektywność operacyjną. Oceniając już dziś swoje obecne wąskie gardła w pamięci masowej i odkrywając wysokowydajne rozwiązania z serii Vincanwo ST, możesz z powodzeniem zabezpieczyć swoje centra danych na przyszłość i zapewnić trwały rozwój firmy.
Chociaż urządzenie pamięci masowej podłączone do sieci jest specyficznym typem pamięci masowej, serwer pamięci masowej dla przedsiębiorstw reprezentuje znacznie szerszą i potężniejszą kategorię architektoniczną. Standardowy serwer NAS jest zazwyczaj zaprojektowany do prostego przechowywania na poziomie plików i podstawowego udostępniania dokumentów w lokalnej sieci biurowej. Natomiast serwer pamięci masowej dla przedsiębiorstw obsługuje pamięć masową na poziomie bloków, ogromną moc obliczeniową do deduplikacji w czasie rzeczywistym oraz wysoce złożone, skalowalne architektury. Te solidne systemy zostały zaprojektowane z myślą o obsłudze wymagających obciążeń, takich jak wirtualizacja na dużą skalę, która szybko przeciążyłaby standardowe urządzenie NAS.
Standardowy cykl życia operacyjnego sprzętu pamięci masowej dla przedsiębiorstw zazwyczaj wynosi od trzech do pięciu lat. Jednakże wysoce skalowalna architektura może skutecznie wydłużyć żywotność funkcjonalną. Wykorzystując konstrukcje modułowe, firmy mogą przeprowadzać aktualizacje fizyczne w sposób niezakłócający pracy. Możesz wymienić starsze dyski twarde na dyski NVMe o dużej pojemności lub dodać nowe węzły obliczeniowe do klastra skalowalnego w poziomie. Dzięki proaktywnej konserwacji dobrze zaprojektowany system może zachować żywotność nawet przez siedem lat.
Tak, ta konfiguracja jest powszechnie znana jako hybrydowa macierz pamięci masowej. Wyrafinowany system płynnie integruje dyski półprzewodnikowe i dyski twarde w tej samej obudowie fizycznej. System wykorzystuje oprogramowanie do automatycznego warstwowania danych w celu dynamicznego zarządzania rozmieszczeniem danych w oparciu o wzorce użytkowania. Przechowuje często używane, gorące dane na ultraszybkiej warstwie półprzewodnikowej, jednocześnie migrując zimne dane na ekonomiczną warstwę dysku twardego.
Dane przedsiębiorstwa rosną w sposób nieprzewidywalny ze względu na takie czynniki, jak integracja sztucznej inteligencji i wydłużone okresy przechowywania zgodności. Skalowalna architektura zapobiega nieoczekiwanemu uderzeniu w barierę twardej pojemności. Skalowalność umożliwia działom IT stopniowe dodawanie węzłów pojemnościowych i wydajnościowych. Dopasowuje to wydatki kapitałowe bezpośrednio do rzeczywistego rozwoju firmy i zapewnia nieprzerwaną codzienną działalność.
Termin „klasa korporacyjna” oznacza ścisłą filozofię projektowania skupioną na zerowej liczbie pojedynczych punktów awarii i ciągłej dostępności danych. Prawdziwy system korporacyjny obejmuje dwa kontrolery pamięci masowej typu aktywny-aktywny, dyski z możliwością wymiany podczas pracy i nadmiarowe zasilacze. Oferuje także zaawansowane usługi danych, takie jak przyspieszana sprzętowo macierz RAID, replikacja synchroniczna i niezmienne migawki w celu ochrony przed oprogramowaniem ransomware.
Obliczanie wydajności obciążeń AI wymaga przeanalizowania rozmiaru szkoleniowych zestawów danych, częstotliwości pozyskiwania danych i zasad przechowywania wygenerowanych modeli. W przeciwieństwie do tradycyjnych baz danych, obciążenia sztucznej inteligencji przetwarzają ogromne ilości nieustrukturyzowanych danych, takich jak obrazy, filmy i pliki dziennika. Inżynierowie zazwyczaj ustalają punkt odniesienia, mnożąc bieżący rozmiar zbioru danych przez oczekiwaną stopę wzrostu w ciągu trzech lat, biorąc jednocześnie pod uwagę dodatkowy bufor o wartości 20–30 procent na miejsce tymczasowe i tymczasowe pliki przetwarzania podczas uczenia modelu.
Sprzętowa macierz RAID opiera się na dedykowanej karcie kontrolera fizycznego zainstalowanej wewnątrz serwera w celu zarządzania parzystością danych i nadmiarowością dysków. Odciąża przetwarzanie z głównego procesora, oferując wysoce niezawodną wydajność dla zlokalizowanych macierzy. Z drugiej strony pamięć masowa zdefiniowana programowo oddziela zarządzanie pamięcią masową od podstawowego sprzętu. Wykorzystuje główny procesor i pamięć RAM serwera do zarządzania danymi w wielu węzłach, umożliwiając ogromną skalowalność poziomą i zaawansowane funkcje, takie jak kodowanie kasujące, które są niezbędne w nowoczesnych infrastrukturach chmurowych i skalowalnych.


